Waarom zou een arts een AI-systeem vertrouwen?
AI-toepassingen duiken steeds vaker op in de geneeskunde. Wat is er nodig opdat een arts een AI-systeem kan vertrouwen?
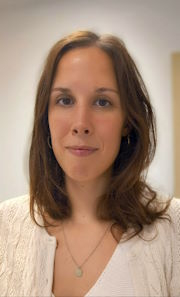
“Ik ontwikkel al meer dan tien jaar medische AI-algoritmen. Maar ik weet nog altijd niet wat de beste manier is om ervoor te zorgen dat artsen een AI-systeem kunnen vertrouwen”, zegt Jennifer Dhont, hoofd Data Science & AI Research bij het Hôpital Universitaire de Bruxelles (HUB) en onderzoeker aan de ULB.
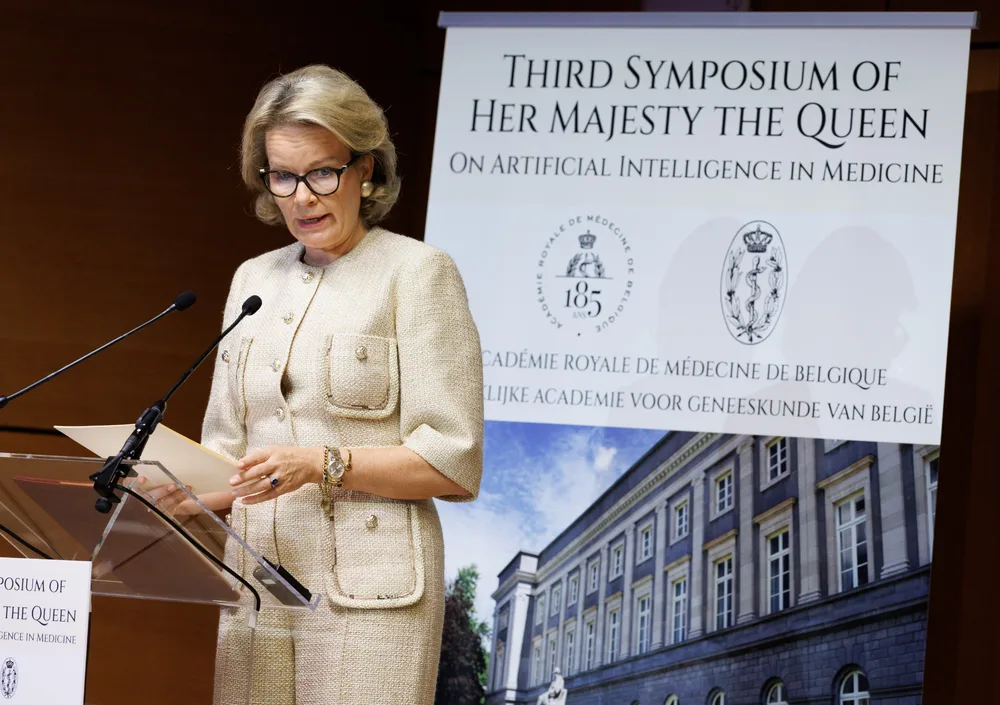
Dhont sprak op het gezamenlijk symposium over AI in de geneeskunde van de Koninklijke Academie voor Geneeskunde en de Académie Royale de Médecine de Belgique.
Dat vertrouwen überhaupt een vraagstuk is, heeft te maken met de manier waarop moderne AI werkt. De algoritmen zijn niet expliciet door een mens geprogrammeerd, maar leren patronen herkennen in enorme hoeveelheden gegevens.
Welke patronen ze precies gebruiken om van een invoer tot een voorspelling te komen, is voor mensen vaak moeilijk te achterhalen. “Er gaat iets in, er gebeurt iets magisch en er komt iets uit. Maar we weten niet hoe we precies moeten interpreteren wat daartussen is gebeurd,” zegt Dhont.
De zwarte doos openen?
Dhont onderscheidt twee mogelijke benaderingen voor dit probleem. De eerste is kiezen voor ‘interpreteerbare AI’: kleinere, eenvoudigere modellen waarvan de werking beter te begrijpen is. Maar dat beperkt de complexiteit van de taken die ze aankunnen. De tweede is ‘verklaarbare AI’ (explainable AI): technieken en methoden die de werking van complexe modellen achteraf inzichtelijk proberen te maken.
Er zijn verschillende argumenten aan te halen om de werking van AI-modellen te verduidelijken – om de ‘zwarte doos’ te openen dus. Dhont zegt zelf door geen van deze vier argumenten overtuigd te zijn.
Er zijn allereerst wettelijke vereisten: de Europese AI Act stelt dat mensen recht hebben op een duidelijke en zinvolle uitleg over de rol van AI bij beslissingen met hoog risico . “Geneeskunde is een risicovolle omgeving, en je zou dus kunnen stellen dat een clinicus zelf moet begrijpen hoe een model tot een bepaalde voorspelling komt”, verduidelijkt Dhont.
Inzicht in hoe modellen werken zou ook nieuwe medische kennis kunnen opleveren, bijvoorbeeld wanneer een AI-model dat getraind is voor radiologie of histopathologie voorspellende kenmerken ontdekt die mensen nog niet herkend hadden.
Er wordt ten slotte ook gesteld dat inzicht in de werking van AI-modellen het risico op bias en ongelijkheid vermindert.
Hoe verklaar je het onverklaarbare?
“Als een methode uitlegt hoe een AI-model werkt, moet die uitleg natuurlijk correct zijn. En daar hebben we volgens mij al een enorm probleem,” zegt Dhont. “We ontwikkelen immers een verklaring voor een model dat we niet volledig kunnen doorgronden. Hoe controleren we dan of die verklaring de werkelijke redenering van het model weergeeft?”
Als concreet voorbeeld noemt Dhont de ontwikkeling van een AI-model om covid-19 op thoraxfoto’s op te sporen. Verschillende onderzoeksgroepen rapporteerden modellen die de infectie zouden kunnen herkennen.
“Ze gebruikten fraaie verklaringstechnieken met mooie kaarten en kleurtjes: kijk, ons algoritme kijkt echt in de longen, dus het moet wel kloppen. Maar uiteindelijk bleek dat helemaal niet zo te zijn”, vertelt Dhont. Wat bleek: de ontwikkelaars hadden beelden van covidpatiënten uit het ene ziekenhuis gecombineerd met beelden van gezonde personen uit een ander ziekenhuis. Het model kon daardoor een schijnbaar correcte diagnose stellen door simpelweg te herkennen uit welk ziekenhuis de opname afkomstig was.
Het illustreert wat ze de ‘vertrouwensparadox’ noemt: een verklaring kan het vertrouwen in een systeem vergroten, ook wanneer ze eigenlijk niet aantoont dat de voorspelling op de juiste gronden berust.
AI als voorschrijfhulp
Een ander voorbeeld dat Dhont aanhaalt, is een studie naar AI-ondersteuning bij de keuze van antidepressiva. Een correct AI-advies zonder verklaring verbeterde de juistheid van de uiteindelijke keuzes van de arts in beperkte mate. Een fout advies deed die daarentegen duidelijk dalen omdat de arts geneigd was AI-advies te volgen.
Het toevoegen van een verklaring hoe het model tot het advies kwam, bracht bij correcte aanbevelingen geen verbetering. Bij foutieve aanbevelingen verslechterden de uiteindelijke beslissing van de arts nog verder wanneer een verklaring werd toegevoegd.
Het onderzoek wijst er volgens Dhont op dat het misschien beter is om AI in zijn zwarte doos te laten zitten, omdat we dan waakzamer en kritischer blijven. Een verklaring kan juist overmatig vertrouwen uitlokken: de gebruiker denkt te begrijpen hoe het model werkt en stelt de uitkomst minder ter discussie.
Klinische validatie als toetssteen
Dhont besluit met een open vraag. Moet een AI-model waarvan de klinische meerwaarde voldoende is aangetoond eigenlijk wel interpreteerbaar zijn?
“Als we bij verschillende populaties en datasets kunnen aantonen dat de modellen werken en tot betere prestaties leiden — uiteraard met een correcte validatie en goede klinische eindpunten — is het dan echt nodig dat we begrijpen wat er in de zwarte doos gebeurt?”